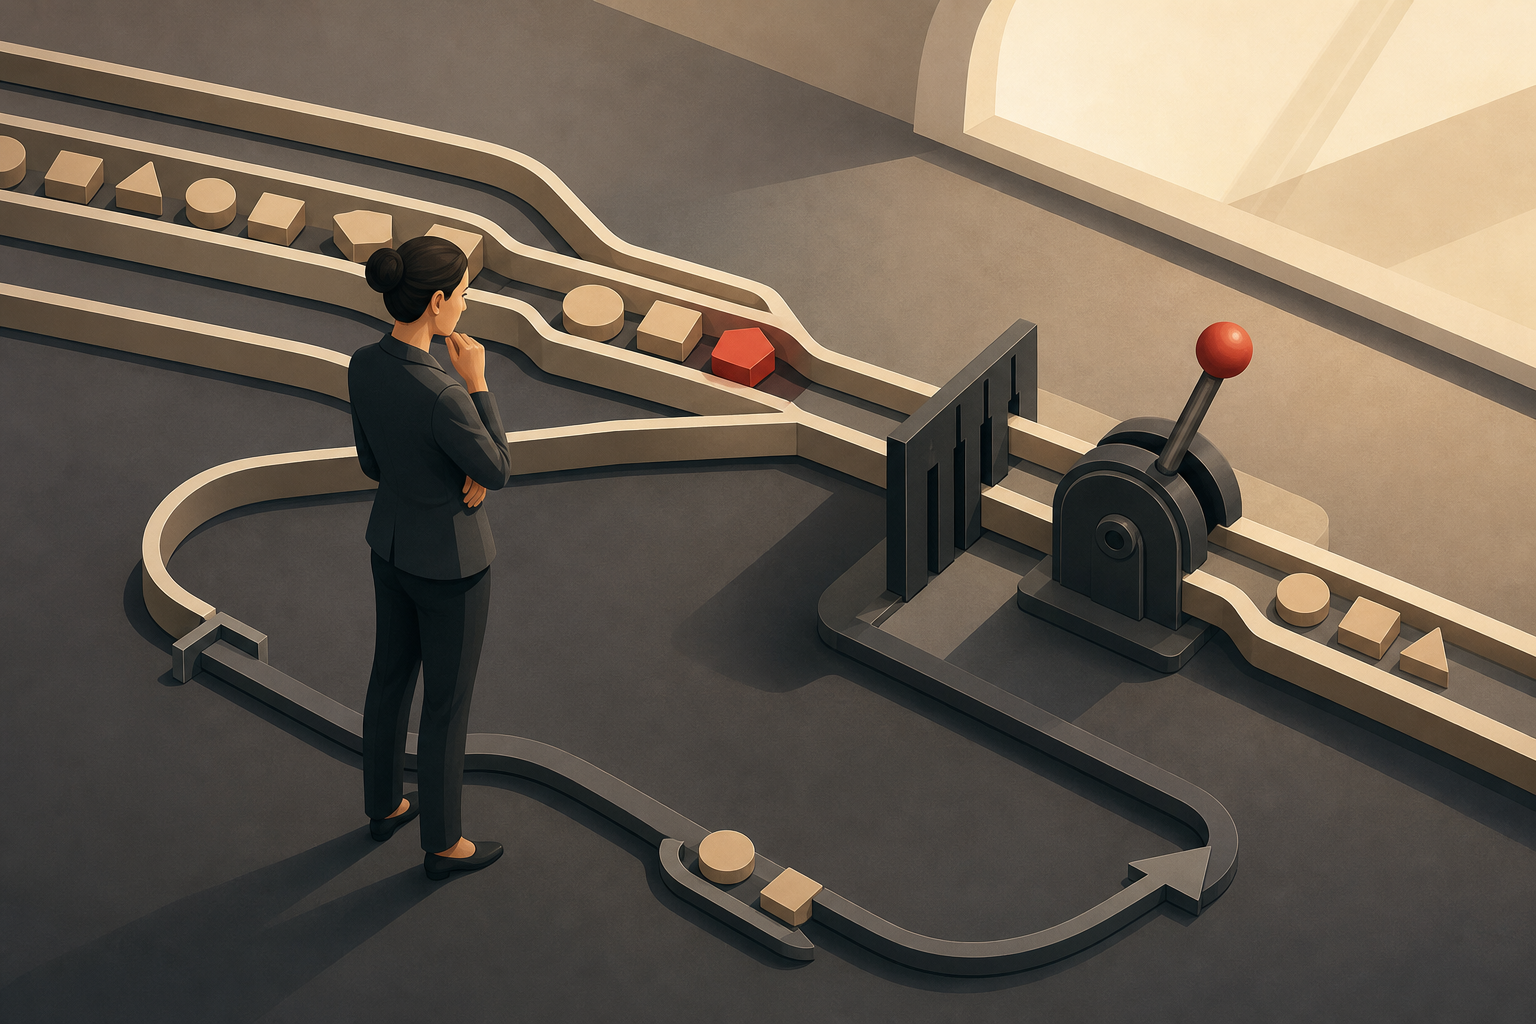
В Ex Machina (2014) доверието е част от самия експеримент: въпросът не е само какво може да направи една система, а какво човекът отсреща е готов да приеме за истина. Филмът е аналогия, не доказателство за реални AI рискове. Но поставя полезен въпрос за киберсигурността: когато хора и AI системи работят заедно, кой проверява решенията, които превръщат информацията в действие?
Краткият отговор е: човешкият фактор в AI сигурността не е външна слабост, която може да бъде отстранена с още едно обучение. Човекът е част от атакуваната система — потребител, оператор, администратор, разработчик или одобряващ решение. Рискът възниква в отношенията между входа, доверието, действието, предоставените права и контрола след това. Затова сигурността трябва да ограничава последствията от грешка, натиск или подвеждане, а не да разчита, че всеки човек винаги ще разпознае опасността.
Човекът е част от системата, не последната ѝ защитна стена
В традиционните модели за сигурност често се говори за потребителя като за „слабото звено“. Това описание е удобно, но непълно. То измества вниманието от архитектурата към отделния човек и внушава, че инцидентът е резултат от невнимание. На практика решенията се вземат в конкретна среда: с ограничено време, непълна информация, работни цели, установени навици и инструменти, които насърчават определено поведение.
AI системите добавят нови посредници към тази среда. Служител може да използва модел, за да обобщи документ; разработчик — да генерира или прегледа код; анализатор — да класифицира сигнали; оператор — да получи препоръка за следваща стъпка. Във всеки случай човекът може да приеме резултата, да го провери, да го промени или да му предостави достъп до следваща система. Самото наличие на човек в процеса не гарантира смислен контрол. Ако той вижда само убедителен отговор, няма време да го провери и може с едно действие да отключи чувствителна операция, „човекът в цикъла“ може да остане формалност.
Това не означава, че AI непременно прави средата по-опасна или че хората не могат да бъдат ефективна защита. Означава, че трябва да разглеждаме цялата последователност: каква информация влиза, на какво се доверяваме, какво действие следва, с какви права и под какъв контрол. Така въпросът се променя от „кой сгреши?“ към „как системата позволи една грешка или измама да се превърне в значимо въздействие?“
Модел за анализ: вход → доверие → действие → права → контрол
Полезен начин да се анализира човешкият фактор е да се проследят пет свързани етапа. Това не е формална таксономия на конкретен стандарт, а практическа рамка за преглед на работни процеси и архитектура.
- Вход: какво вижда човекът или AI системата — съобщение, документ, заявка, резултат от инструмент или сигнал от друга услуга?
- Доверие: защо входът изглежда достоверен и какво реално е проверено — самоличност, произход, цялост, контекст или само стил и познат формат?
- Действие: какво следва от оценката — отваряне, одобрение, споделяне, промяна на настройка, изпълнение на команда или препращане на препоръка?
- Права: какво може да направи човекът или системата след това и докъде се простира достъпът им?
- Контрол: може ли действието да бъде ограничено, потвърдено, регистрирано, открито или отменено?
Рамката помага да се види защо обучението само по себе си не е контрол. Ако служителят разпознае съмнителна заявка, но процесът му позволява да промени достъп без независима проверка, рискът остава. Ако моделът отхвърли подозрителен вход, но следващият компонент изпълни същото действие с широки права, отказът може да бъде заобиколен от дизайна на системата. А ако логовете не показват кой е подал заявката и как е одобрена, разследването след инцидент ще бъде затруднено.
При преглед на процеса задайте въпросите по веригата, а не само на входа. Кой може да подаде информация? Кой я приема за надеждна? Как се стига от текст или препоръка до промяна в система? Какви права са нужни за тази промяна? Кой или какво може да я спре? Отговорите често разкриват, че слабостта не е в един човек или модел, а в прехода между отделни компоненти и отговорности.
Human Hacking: натискът е част от заплахата
Социалното инженерство използва човешко доверие, роля, навик или натиск, за да предизвика действие, което иначе може да бъде отказано или проверено. То не се свежда до очевидно фалшиво съобщение с правописни грешки. Заявката може да изглежда рутинна, да използва познат вътрешен процес или да се появи в момент, когато човекът трябва да решава бързо. Нападателят не е задължително да преодолее техническата защита, ако може да убеди упълномощен човек да извърши действието вместо него.
AI променя мащаба и формата на подобни опити, но не отменя основния механизъм. Генеративните инструменти могат да помогнат за създаване на по-гладък, контекстуално убедителен текст или за приспособяване на послание към конкретна ситуация. Това не означава, че всяко персонализирано съобщение е създадено с AI, нито че автоматизиран текст непременно е убедителен. Практическият извод е по-тесен: грамматика, тон и познат контекст сами по себе си вече не са надеждна проверка на произхода.
Натискът също не е дефект на жертвата. Спешност, авторитет, страх от прекъсване на работа и очакване за бързо обслужване могат да влияят на преценката. В организацията тези фактори често са заложени в самия процес: служителите се оценяват по скорост, изключенията се решават неформално, а повторното потвърждение се възприема като пречка. Когато една измама успее при такива условия, обвинението към конкретния служител не поправя дизайна, който е направил заобикалянето удобно.
Затова защитата трябва да осигурява безопасен начин да се спре и провери необичайна заявка. Процедурата трябва да е достъпна и приложима под натиск, а не само описана в документ. На служителя трябва да е позволено да откаже или отложи действие, без да бъде наказан за спазването на проверката. Ръководителите също трябва да демонстрират, че правилата важат и при спешни задачи или заявки от влиятелни колеги.
Тук е важна границата между човешка проверка и прехвърляне на отговорността. Човекът може да оцени контекст, който автоматизацията не разбира, но не бива да се очаква да компенсира липсата на надеждна идентификация, ограничени права или проследимост. Ако един разговорен отговор от AI звучи убедително, това не доказва, че зад него стои проверен източник. Ако съобщение носи име на ръководител, това не удостоверява самоличността на подателя. Проверяването трябва да стъпва на независим сигнал, а не на същото съдържание, което поражда съмнението.
AI Attack Surface: когато данните и инструкциите се срещнат
Повърхността за атака на AI система включва не само модела и неговия интерфейс. Тя може да обхваща документите, които системата търси или обобщава, външни услуги, добавени инструменти, права за достъп и хората, които приемат резултатите. При система за генериране с извличане от документи (RAG) моделът получава намерена информация като контекст, за да отговори на въпрос. Документът може да е полезен за задачата, но това не прави съдържанието му автоматично надеждна инструкция.
Непряка инжекция на подсказки е термин за ситуация, в която инструкции, вложени в недоверено съдържание, се опитват да повлияят на поведението на модел, когато той обработва това съдържание. Разликата спрямо директната заявка е, че проблемното указание може да се намира в документ, страница или друг източник, а не в текста, въведен непосредствено от потребителя. Това е проблем на границите на доверие: данните, които трябва да бъдат прочетени, могат да съдържат текст, приличащ на команда.
Самото наличие на такъв текст не доказва пробив. Резултатът зависи от архитектурата, инструкциите, достъпните инструменти и разрешените действия. Демонстрация, при която моделът е подведен да отговори по нежелан начин, не е равнозначна на компрометиране на реална система или изтичане на данни. Но тя може да разкрие проектен риск, особено ако моделът има достъп до чувствителни източници или може да задейства действия без отделно одобрение.
NIST в профила си за генеративен AI, NIST AI 600-1, разглежда рискове, свързани с използването и управлението на генеративни системи. Той е рамков документ за управление на риска, а не гаранция, че конкретен продукт е безопасен. По същия начин OWASP Top 10 for LLM Applications включва prompt injection сред рисковете за приложения с езикови модели. Тези препратки помагат да се класифицира проблемът, но не заменят прегледа на конкретните граници, данни и разрешения в една организация.
За този стълбов материал е важно общото правило: съдържанието, което системата получава, не трябва автоматично да придобива правомощия само защото моделът го е прочел. Това е същият принцип, който важи за човешкия процес. Информацията може да насочи решение, но произходът ѝ и правото ѝ да предизвика действие са отделни въпроси. По-конкретния механизъм, включително взаимодействието между RAG, недоверени документи и инструкции, разглеждаме в материала за непряката инжекция на подсказки.
Граници на доверие: нека съдържанието не се превръща в право
Граница на доверие е място, където информация, идентичност или управление преминават от една зона в друга и трябва да бъдат проверени според новите условия. Такива граници има между служител и услуга, между вътрешна и външна информация, между модел и инструмент, между препоръка и одобрено действие. В системи с AI тези преходи могат да бъдат по-трудни за забелязване, защото интерфейсът представя резултата като единен разговор, макар под него да работят различни компоненти и източници.
Практическият риск е смесването на различни свойства. Текстът може да бъде четим, но не и достоверен; достоверен, но не и актуален; актуален, но да няма право да задейства промяна. Отговорът може да е полезен, но все пак да съдържа грешка. Потребителят може да е автентикиран, но да няма нужда от права за конкретна операция. Сигурният дизайн не свежда тези въпроси до един общ етикет като „вътрешно“, „одобрено“ или „AI проверено“.
Това изисква ясно разделение между извличане на информация и изпълнение на действие. Модел, който обобщава документ, не трябва по подразбиране да може да променя настройка или да изпраща чувствителни данни. Ако бизнес процесът изисква автоматизирано действие, то трябва да бъде ограничено до конкретна задача и да има подходящи проверки. Важни операции могат да изискват отделно потвърждение през канал, който не разчита на същия вход, довел до предложението.
Същата логика се прилага към човешките роли. Човек, който подготвя заявка, не е непременно подходящият единствен одобряващ; оператор, който извършва промяна, не трябва автоматично да има неограничен достъп до всички системи. Разделянето на задълженията не е недоверие към служителите. То намалява възможността грешка, компрометиран акаунт или подвеждаща заявка да доведе самостоятелно до необратимо действие.
The Illusion of Security: контролът може да съществува само на хартия
Илюзията за сигурност възниква, когато наличието на контрол се приема за доказателство, че реалният риск е покрит. Организацията може да има обучение, многофакторна автентикация, филтриране на съобщения, преглед на AI резултати и процес за одобрение — и пак да остави опасен път към целта. Контролите могат да бъдат заобиколими, да не покриват определен канал или да се прилагат само в нормални условия.
Например, правило за проверка на самоличността е слабо, ако служителите могат да го отменят при натиск без следа. Човешкият преглед е слаб, ако проверяващият получава резултат без източници и няма време или компетентност да го оспори. Филтърът е слаб, ако неговият пропуск се превръща незабавно в действие с високи права. А политиката за безопасна употреба на AI е слаба, ако служителите не знаят кои данни могат да въвеждат или не разполагат с одобрен инструмент за работата си.
Илюзията може да идва и от прекалена увереност в собствената преценка. Moore и Healy в обзорната си работа за свръхувереността разглеждат различни значения на термина, включително оценяване на представянето, на собственото място спрямо другите и на точността на убежденията. Това не подкрепя опростеното твърдение, че всеки човек надценява умението си във всяка задача. То напомня, че увереността и реалната точност са различни величини и че връзката между тях зависи от задачата и начина на измерване.
В киберсигурността това има конкретно значение: „аз ще го позная“ не е контрол, който може да бъде проверен без измерване. Нито един резултат от тест или обучение не гарантира, че човекът ще реагира правилно при всякакви условия. Тестът може да използва по-лесни или по-трудни примери, участниците може да познават формата му, а поведението в упражнение да се различава от поведението под реален натиск. Затова оценката трябва да разглежда повече от един показател и да се тълкува според контекста.
Същото важи за AI. Успешно преминаване на тестов набор не доказва устойчивост към всички видове входове или промени в системата. Лабораторна демонстрация не е автоматично доказателство за реална експлоатация. От друга страна, липсата на известен инцидент не доказва, че пътят е безопасен. Полезната позиция е да се разделят наблюдаваните факти, предположенията за възможна злоупотреба и решенията за управление на риска.
Как да превърнем принципите в работещи контроли
Първата стъпка е да се опише конкретният работен процес, а не само AI модела. Проследете данните от източника до крайното действие: кой ги въвежда, къде се съхраняват, кой ги обработва, какъв резултат се показва и какво може да последва. Отбележете къде системата приема външна информация, къде човекът одобрява промяна и къде се пресичат различни роли или права. Това дава основа за оценка, която съответства на реалния процес.
След това приложете принципа на най-малките привилегии: всеки участник получава само достъпа, нужен за задачата му, за необходимото време. Ограничете инструментите, които моделът може да използва, и отделете четенето от записването или изпълнението. За чувствителни операции обмислете независима проверка, а не потвърждение, което просто повтаря същите данни. Ако действието може да има значими последствия, предвидете начин за спиране или отмяна, когато това е приложимо.
Проверявайте самоличността и правото за действие като различни неща. Успешното влизане не означава автоматично, че заявката е легитимна или че акаунтът трябва да може да извърши всяка промяна. За чувствителни заявки определете подходящ процес за потвърждение чрез независим канал и ясно задайте кога е нужна ескалация. Подробните процедури за обслужващи екипи и нулиране на достъп са отделна задача; вижте анализа за атаки срещу help desk и проверка на самоличност.
Тествайте системата като съчетание от технология и работен процес. Проверявайте не само дали моделът отговаря правилно на стандартна заявка, а и как системата се държи при неочакван, подвеждащ или непълен вход; какво може да направи свързан инструмент; как реагира човекът на предупреждение; и дали необичаен случай действително стига до независим преглед. Тестовете трябва да отразяват реалните права и интеграции, но да се изпълняват по контролиран начин, без да се излагат чувствителни данни или продукционни услуги на ненужен риск.
Наблюдението трябва да обхваща събитията, нужни за разбиране на решенията: използвания източник, задействан инструмент, извършена промяна, одобрение и отказ. Логването следва да е съобразено с целта и правилата за поверителност, а не да събира неограничено съдържание „за всеки случай“. Организацията трябва да знае кой преглежда сигналите, как се разследват отклоненията и как се актуализират контроли, когато процесът или моделът се промени. Без определена отговорност наблюдението лесно се превръща в данни, които никой не използва.
Обучението е полезно, когато е свързано с конкретни решения и поддържано от правилно проектирани процедури. То може да научи служителите как да поставят под съмнение произхода, да съобщават подозрителни заявки и да различават препоръка от одобрено действие. Но не бива да се използва като заместител на технически ограничения. Ако служителите трябва непрекъснато да разпознават опасността сами, докато работят под натиск, това е сигнал да се преразгледа процесът, а не просто да се добави още една презентация.
Измервайте поведението на системата, не само намеренията
Ефективността на контрола се вижда в това какво става при отклонение. Може ли необичайна заявка да бъде отложена без наказание за служителя? Съществува ли път за съобщаване на съмнение? Ограничени ли са последствията, ако човекът или моделът приеме погрешен вход? Може ли организацията да установи откъде е дошло решение и кой го е одобрил? Такива въпроси са по-полезни от общото твърдение, че „хората са обучени“ или че „AI има човешки надзор“.
Когато се използват симулации, тестове или метрики за реакция, контекстът има значение. Един показател не описва цялата способност на хората или надеждността на процеса. Резултатите могат да помогнат да се открият неясни процедури, прекомерно натоварване или слабо работещи предупреждения, стига да не се използват за засрамване и наказване на участниците. Измерването трябва да води до подобрение на системата: да се променят интерфейсът, правата, каналът за потвърждение или начинът за ескалация.
За AI функциите добавете оценка при промяна на модел, набор от документи, интеграция или ниво на достъп. Контрол, който е бил достатъчен за инструмент само за обобщаване, може да не е достатъчен, ако той по-късно изпраща съобщения или променя записи. Техническото обновяване може да промени и начина, по който хората възприемат резултатите. Затова управлението на риска не е еднократна сертификация, а повтарящ се преглед на системата в нейния актуален контекст.
Кой проверява проверяващия?
Човешкият фактор в AI сигурността не е проблем, който се решава с избор между „да се доверим на човека“ и „да се доверим на модела“. Трябва да знаем какво е проверено, какви права има всеки участник и какво ограничава последствията при грешка. Хората могат да забелязват контекст и несъответствия; автоматизацията може да подпомага последователността и обработката на информация. Нито едното е надеждна защита без ясни граници, проверими процеси и възможност за оспорване.
Когато човек проверява AI, проверката трябва да бъде реална: да има достъп до подходящ контекст, време за преценка и правомощие да спре действие. Когато AI подпомага човек, системата не бива да представя убедителен отговор като доказателство за истинност или разрешение за действие. А когато организацията оценява собствената си сигурност, тя трябва да гледа отвъд наличието на политика и да пита дали контролът работи при натиск, грешка и подвеждаща информация.
Това е смисълът на веригата вход → доверие → действие → права → контрол. Тя показва къде една заявка става решение, къде решението получава власт и къде тази власт може да бъде ограничена. Започнете от реален процес, намерете границите на доверие, проверете правата и тествайте пътя до действието. Така отговорността не се стоварва върху последния човек, който е кликнал, а се разпределя там, където може да се управлява рискът — в дизайна и експлоатацията на цялата система. Вижте също: Ти би разпознал фишинга. На какво се основава увереността ти?.