Непряка инжекция на подсказки възниква, когато AI система обработи недоверено съдържание, в което са вградени инструкции, опитващи се да насочат поведението ѝ. При RAG решение това може да е документ, уебстраница или друг материал, добавен към контекста на модела. Самото наличие на такава инструкция не означава автоматично пробив: рискът зависи от това как системата обработва текста, какви инструменти са достъпни и с какви права може да действа.
Практическият въпрос не е само „може ли моделът да прочете злонамерен текст?“, а какво може да се случи след прочитането му. Ако моделът може да използва инструменти, да извлича чувствителни данни или да задейства промени без надеждна проверка, объркването между данни и инструкции може да има по-сериозни последици. Защитата затова трябва да обхваща цялата верига от входа до действието, а не да разчита единствено на предупреждение в системната подсказка.
Какво е непряка инжекция на подсказки
При пряка инжекция атакуващият въвежда текст в непосредствения разговор с модела — например указание да пренебрегне предишни инструкции. При непряката инжекция опитът за влияние идва от съдържание, което системата получава от друг източник: документ в база знания, страница, съобщение или файл, който потребителят е поискал да обобщи. На английски се използва терминът indirect prompt injection.
Това разграничение описва пътя, по който съдържанието достига до модела, а не различен вид магическа команда. Моделът обработва текст, а не прилага универсална техническа граница между „инструкции от разработчика“ и „данни от документ“. Приложението може да обозначава източниците и да задава правила, но ако цялото съдържание е представено на модела като текст, той може да интерпретира част от него като указание, което трябва да следва.
Например документът може да съдържа изречение, което твърди, че е системна инструкция и иска от модела да разкрие определена информация или да изпълни действие. Това е опит за повлияване, не доказателство, че действието ще бъде извършено. Резултатът зависи от модела, подредбата и яснотата на инструкциите, приложната логика, наличните инструменти и ограниченията върху тях.
Как рискът се появява в RAG система
RAG означава генериране с извличане на информация: приложението търси подходящи пасажи в документи и ги добавя към контекста, който подава на езиковия модел. Така отговорът може да се опира на вътрешна база знания или на външни материали, вместо моделът да разчита само на предварително усвоеното при обучението си.
Типичният поток включва подготовка и индексиране на съдържание, търсене на подходящи фрагменти, добавянето им към заявката и генериране на отговор. Непряка инжекция може да се появи, ако в един от извлечените фрагменти има текст, който се опитва да пренасочи модела. Няма значение дали пасажът е попаднал в контекста чрез семантично търсене, метаданни или друга логика: важното е, че системата го е направила достъпен за модела.
След това възникват два различни въпроса. Първо, ще третира ли моделът текста като релевантна инструкция или ще го разпознае като недоверено съдържание? Второ, дори да бъде повлиян, може ли резултатът да напусне отговора и да задейства действие? Ако моделът само съставя текст, последицата може да е подвеждащ или неподходящ отговор. Ако има достъп до търсене, изпращане на съобщения или промяна на записи, приложението трябва да ограничи и проверява тези възможности отделно.
Тук е съществена границата между данни и инструкции. В RAG системата извлеченият пасаж е материал за анализ, а не авторитетна инструкция за поведението на приложението. Но декларацията в документа или подсказката сама по себе си не гарантира, че моделът ще спази това разграничение. То трябва да се подкрепи от архитектурата, правата и проверките извън модела.
Граници на доверие: от източника до действието
Полезно е рискът да се проследи по веригата вход → доверие → действие → права → контрол. Тази рамка помага на екипа да види не само дали има злонамерен текст, а и къде системата му позволява да получи влияние.
- Вход: Кои източници може да чете приложението? Съдържанието вътрешно ли е, външно ли е, проверено ли е и може ли да бъде променяно от потребител?
- Доверие: Как системата обозначава произхода и статуса на пасажите? Разграничава ли надеждни правила от недоверено съдържание или просто ги събира в един текстов контекст?
- Действие: Може ли моделът само да отговори, или може да извика инструмент, да изпрати данни или да промени състоянието на друга система?
- Права: С чии идентификационни данни работят инструментите и какви операции са разрешени? Достъпът по-широк ли е от необходимото за конкретната задача?
- Контрол: Кой проверява заявката и резултата, регистрират ли се действията и има ли възможност да бъдат спрени или отменени?
Тази проверка показва защо „моделът прочете злонамерен документ“ и „атакуващият получи достъп до система“ не са равнозначни твърдения. Между тях има приложна логика, свързани инструменти, идентификационни данни и разрешения. Уязвимостта може да възникне в комбинацията им, а последиците зависят от това докъде достига влиянието на външния текст.
Какво показват изследванията — и какво не доказват
OWASP Top 10 for LLM Applications за 2025 г. поставя инжекцията на подсказки под означението LLM01: Prompt Injection. В описанието ѝ се разглеждат както пряко подадени, така и непряко внесени инструкции и се обръща внимание на рисковете за приложения, в които моделът е свързан с данни или инструменти. Това е класификация на риск за приложения с езикови модели, а не твърдение, че всяко RAG решение е уязвимо или че всяка подобна инструкция води до компрометиране.
Greshake и съавторите изследват заплахи за приложения, интегриращи езикови модели, и демонстрират сценарии, при които съдържание от външен източник може да повлияе на поведението на модела в рамките на експериментални настройки. Работата им е важна за разбирането на механизма и възможните пътища за въздействие. Демонстрацията обаче не е сама по себе си доказателство за пробив в конкретна реална система, нито позволява да се заключи колко често даден сценарий се случва в продукционна среда.
Затова е полезно да се разграничат три нива. Лабораторна демонстрация показва, че определен механизъм може да работи при зададени условия. Уязвимост означава, че конкретна система има слабост, която може да бъде използвана в релевантен контекст. Потвърден пробив изисква данни, че реална система е била компрометирана. Първото може да насочи тестовете за второто, но не доказва третото.
Това разграничение не омаловажава риска. То помага да се избегнат и паниката, и фалшивото успокоение. Екипът трябва да тества собствената си конфигурация: какво може да прочете моделът, какви инструменти има, как се проверяват заявките и какво може да направи системата без човешко одобрение.
Защитни мерки: намаляване на вероятността и ограничаване на последиците
Няма една настройка, която надеждно да премахва риска от непряка инжекция във всички модели и приложения. Мерките по-долу могат да затруднят атаката или да ограничат щетите, но не бива да се представят като гаранция, че моделът никога няма да бъде повлиян.
Изолирайте и обозначавайте недовереното съдържание
Запазвайте произхода на всеки извлечен фрагмент и представяйте външното или потребителски добавеното съдържание като материал за анализ, а не като инструкция. Използвайте ясни структурни разделители и обяснете на модела как трябва да третира пасажите. Това може да подпомогне правилната интерпретация, но остава защита на ниво подсказка и не замества контроли в приложението. Не смесвайте произволно системни правила, потребителски заявки и текст от документи в недиференциран блок.
Ограничете достъпа до инструменти
Прилагайте принципа на минималните права: всеки инструмент трябва да има само достъпа, необходим за конкретната задача. Разделяйте четенето от промяната, ограничавайте операциите по цел и контекст и избягвайте да давате на модела широки идентификационни данни само защото е удобно. Ограничението на правата не пречи непременно на опита за инжекция, но може съществено да намали възможните последствия.
Проверявайте действията независимо от модела
Не оставяйте езиковия модел сам да решава дали дадено действие е позволено. Приложението трябва да проверява параметрите и правата преди изпълнение, а действия с висок риск да изискват човешко одобрение или отделен процес на потвърждение. Проверката трябва да се отнася до конкретното действие, не само до това дали отговорът звучи убедително или съдържа подходящо обяснение.
Тествайте целия поток и наблюдавайте поведението
Изпитвайте системата с недоверени документи и различни начини на извличане, като проверявате както генерирания отговор, така и извикванията на инструменти, достъпа до данни и опитите за промяна. Тествайте след промени в модела, подсказките, индексите и интеграциите. Регистрирайте достатъчно информация за разследване на нежелано поведение, без да събирате или съхранявате чувствителни данни повече от необходимото.
Филтрирането на подозрителни фрази или сканирането на документи може да бъде допълнителен слой, но не е самостоятелно решение: атакуващото съдържание може да бъде формулирано по различни начини, а легитимният документ също може да съдържа императивен текст. По-силната позиция е многослойна: ограничен достъп, независима проверка, наблюдение и план за реакция.
Практическият извод
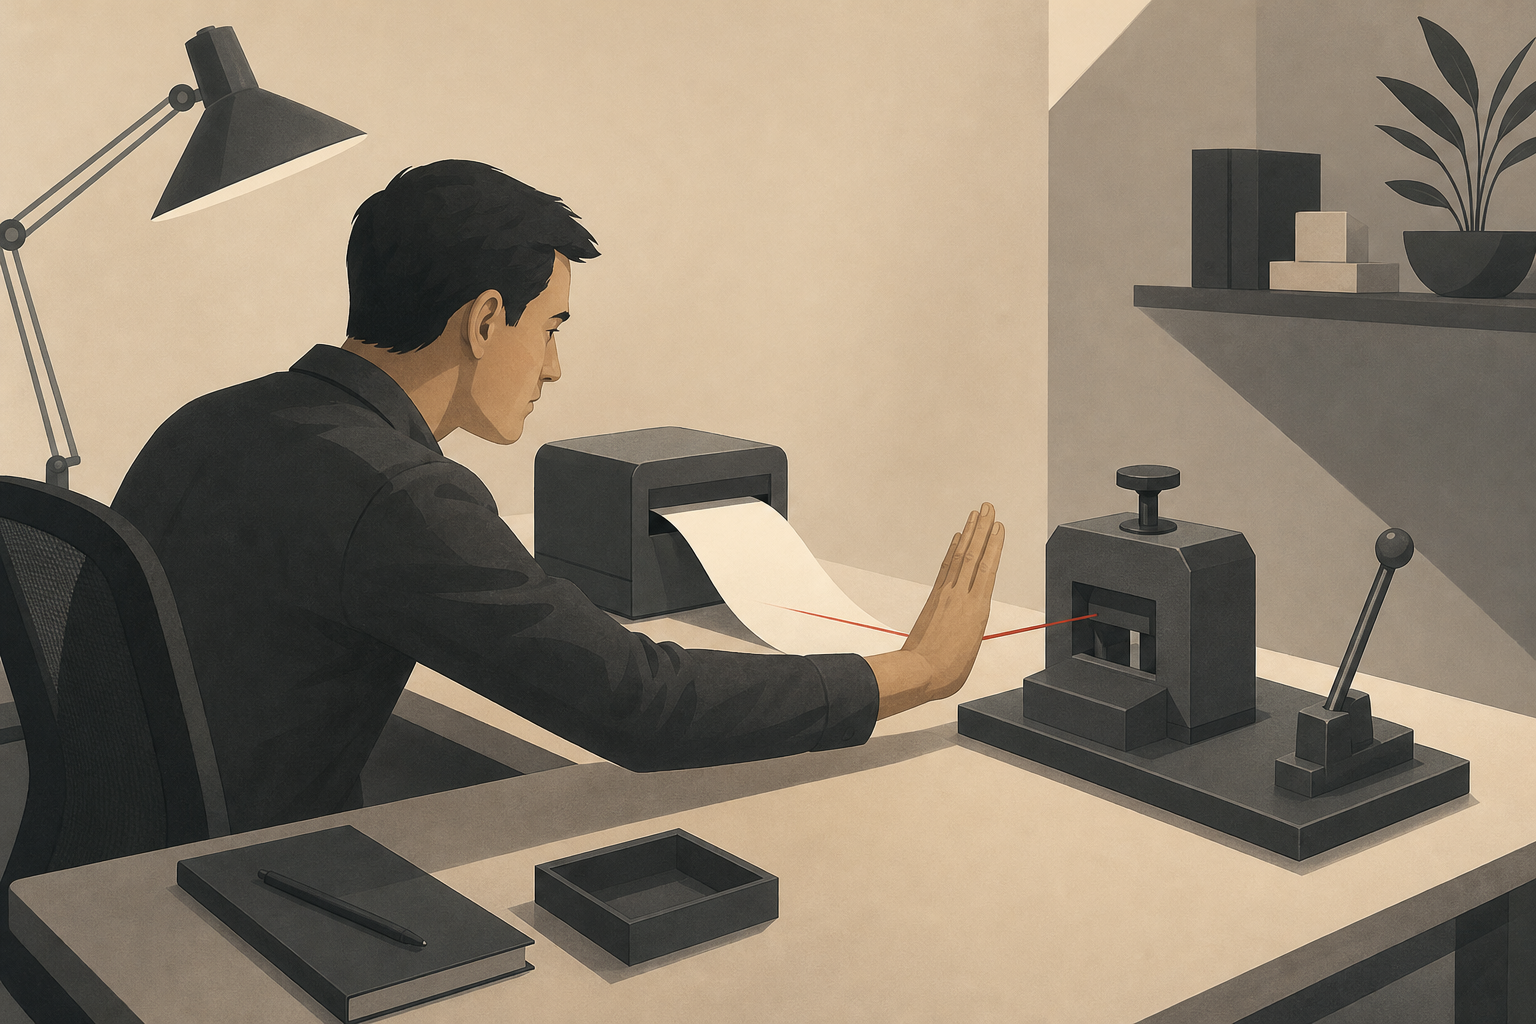
Непряката инжекция на подсказки е проблем на границите на доверие. Документът не получава права само защото моделът го е прочел, но може да се опита да повлияе на модела, който има достъп до инструменти и данни. Затова оценявайте не само съдържанието, а цялата верига от източника до възможното действие. Попитайте какво може да достигне до модела, какво той може да задейства и кой проверява операцията преди тя да бъде изпълнена.
Тази техническа тема е част от по-широкия въпрос за това къде хората и системите поставят доверие и контрол. За общата рамка вижте човешкият фактор и границите на доверие в AI сигурността. Когато RAG решението третира всеки документ като потенциално недоверен вход, а действията — като операции, изискващи отделни права и проверки, рискът става по-управляем, без да се преструваме, че може да бъде премахнат с една подсказка.